Apple только что посадила своих инженеров на AI-бюджет. Мы сидим на таком с первого дня.
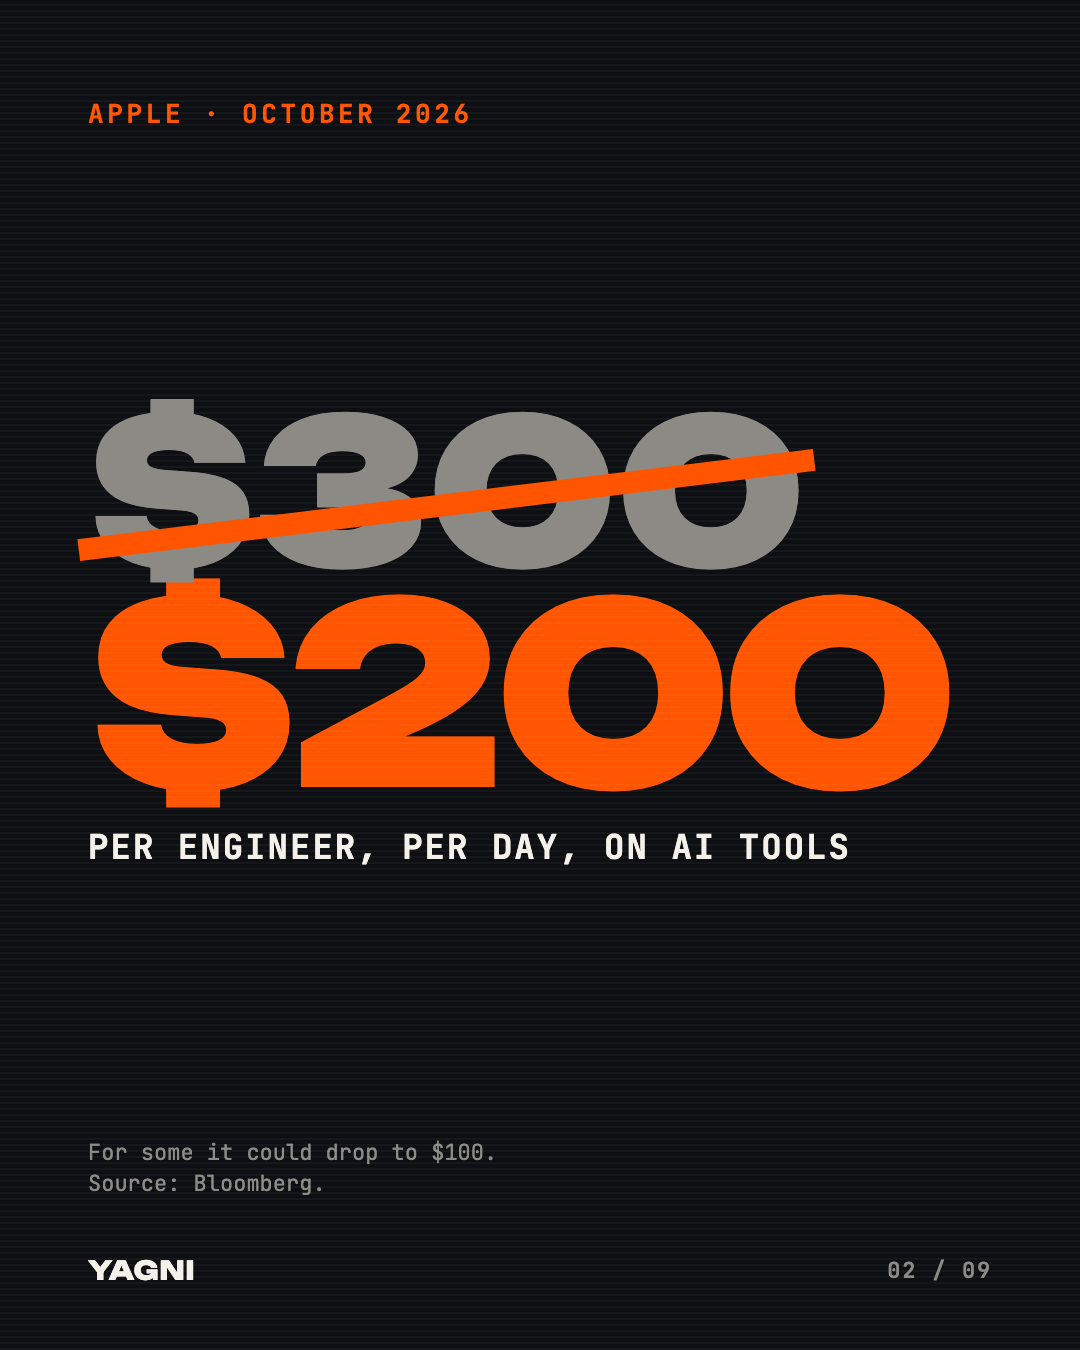
Bloomberg сообщил, что в октябре Apple снизила дневную сумму, которую часть инженеров может тратить на внешние AI-инструменты, включая Claude и ChatGPT, с $300 до $200, а для некоторых она может упасть до $100 (Yahoo Finance). В том же месяце Goldman Sachs оставил Claude Code своим инженерам, а у большинства трейдеров и банкиров его забрал, сославшись на продуктивность и риски (Yahoo Finance).
Ни одна из компаний не сказала, что AI не работает. Обе, каждая по-своему, сказали, что время, когда никто не смотрит на счёт, закончилось.
В YAGNI мы строим команды агентов, которые доводят тикет до pull request, и с самого начала считаем стоимость каждого PR. Поэтому, когда я прочитал про дневной лимит в $200, первым делом спросил себя, на сколько pull request его хватит. Ниже наши цифры, включая одну, в которой я ошибся на прошлой неделе.
Сколько стоит один PR на нашем бенчмарке
Мы ведём бенчмарк из восьми репозиториев на разных стеках: .NET, Go, PHP, Django, Rails, Yarn-воркспейс, проект на OpenTofu и наше собственное приложение. Агенты там работают над тикетами постоянно, а CI записывает, сколько стоил каждый тикет.
С 13 октября по 3 ноября получилось 950 pull request. Стоимость — это то, что записал наш биллинг за весь тикет, включая все попытки, а не списочные цены, умноженные на токены.
- Медиана: $0,61 за pull request.
- 90-й перцентиль: $2,37.
- Самый дорогой: $10,49. Самый дешёвый: $0,13.
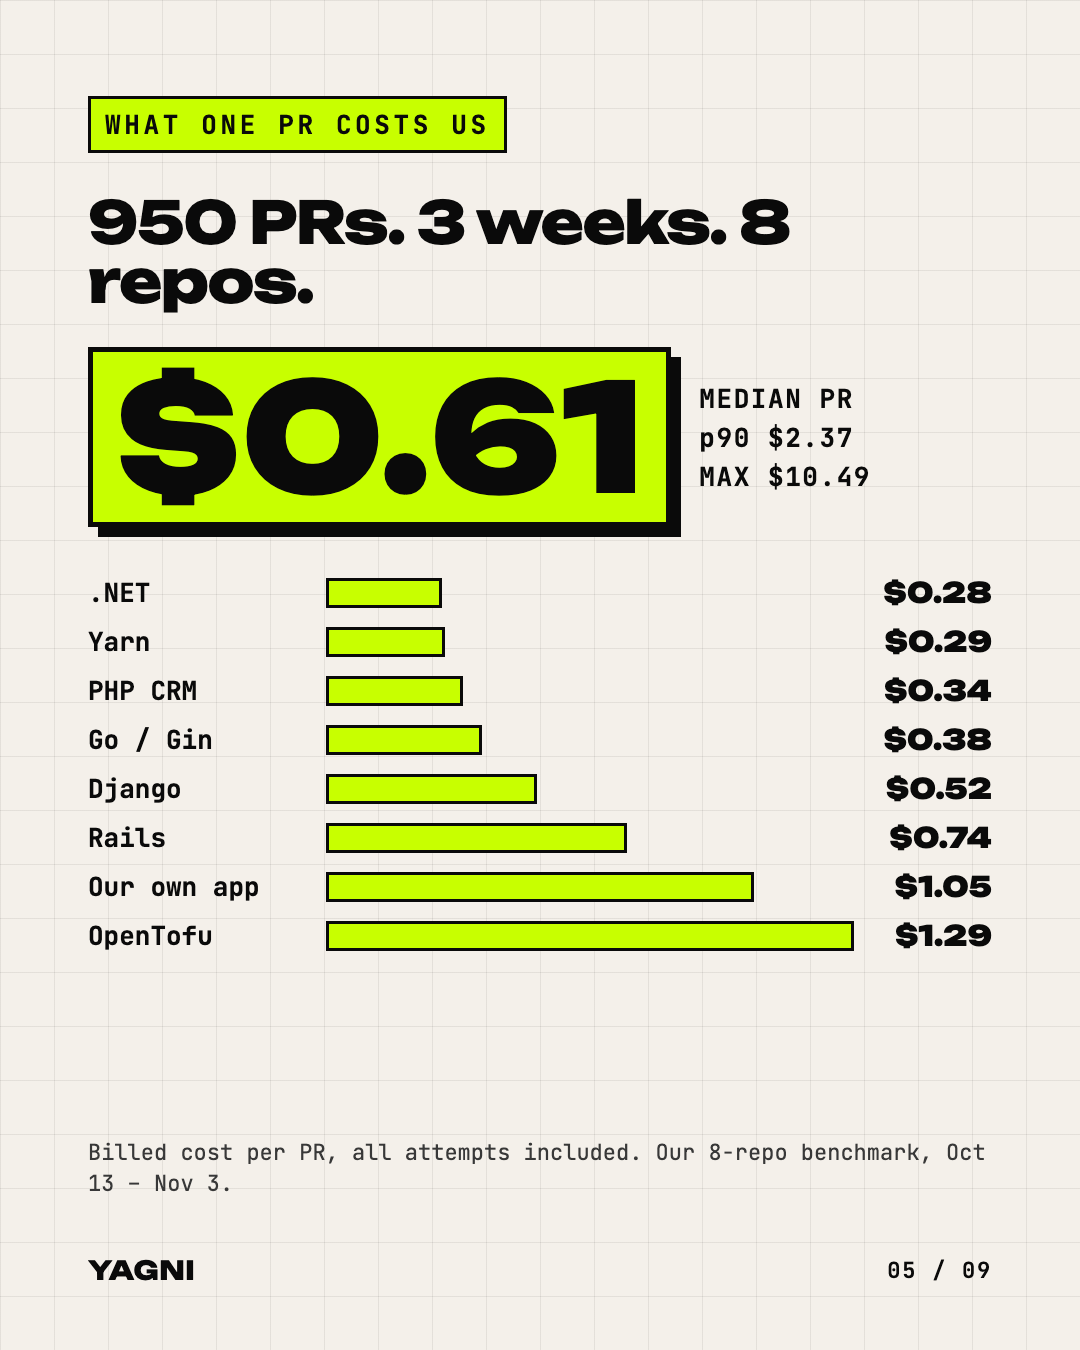
Разброс больше зависит от стека, чем от тикета. Типичный фикс на .NET или Yarn стоит меньше 30 центов. Инфраструктурный код и наше приложение, где агенту перед правкой нужно прочитать больше контекста, обходятся примерно в четыре раза дороже.
Что дают $200 в день
По нашей медиане новый лимит Apple — это 328 pull request в день.
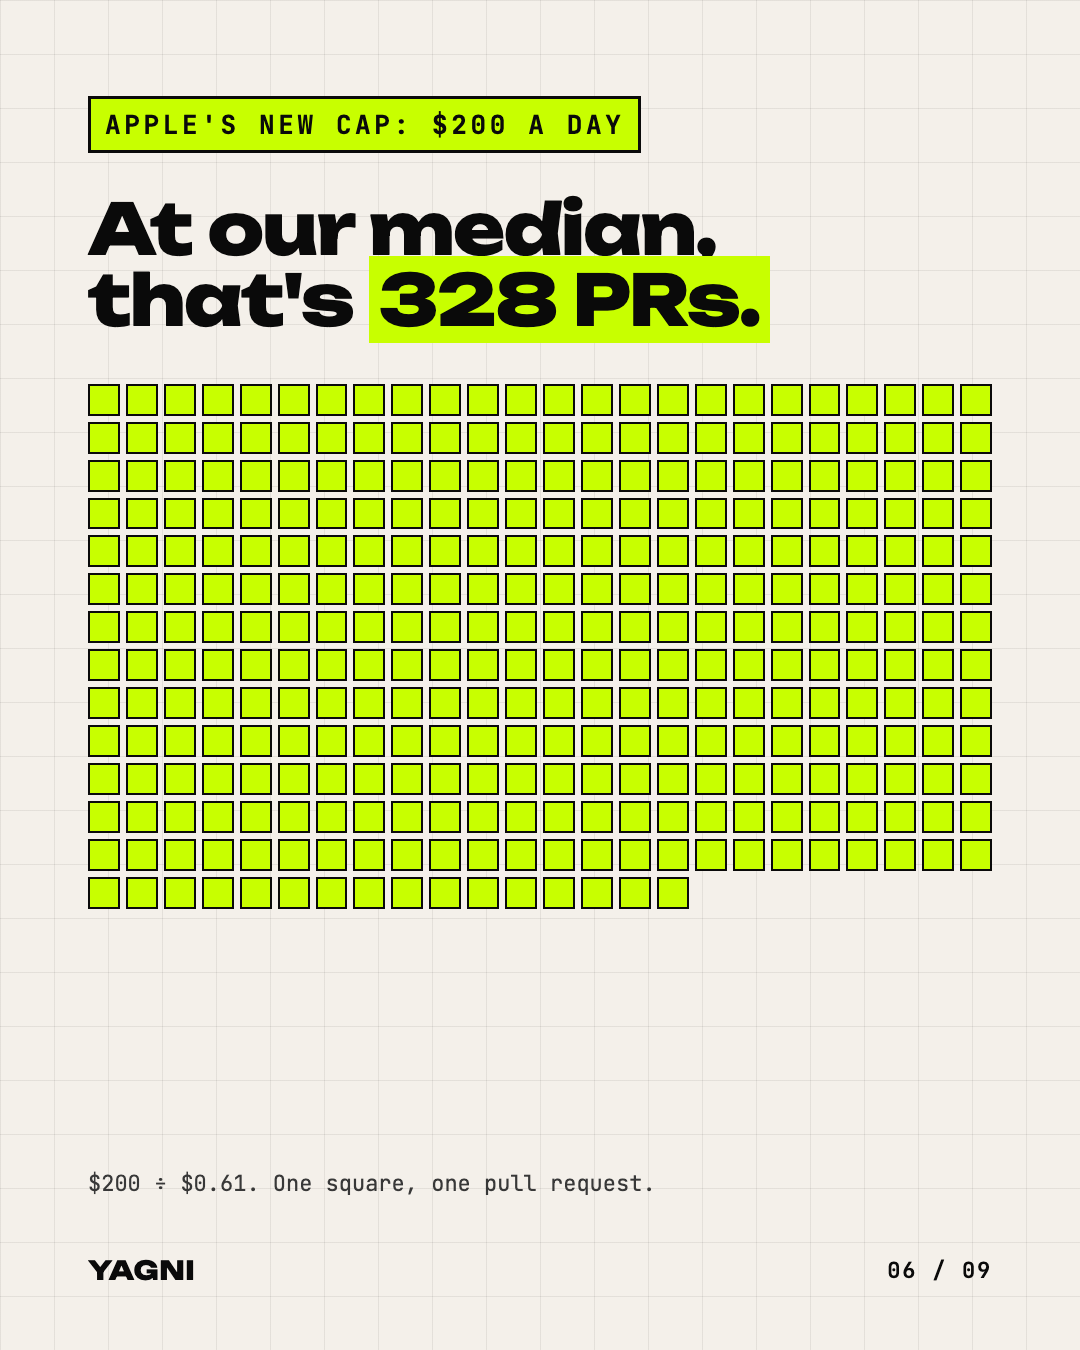
Сравнение выгодно для нас, и я хочу честно сказать почему. Тикеты в бенчмарке меньше, чем большая часть продуктовой работы: поправить эндпоинт, добавить валидацию, обновить конфиг. Настоящая фича стоит дороже, а когда что-то идёт не так, ломается так, что медиана этого не показывает.
Самый дорогой PR, который мы видели
На стейджинге, во внутреннем тестовом проекте, самый дорогой тикет на Opus 5.5 стоил $54,82. Агент планировал, реализовывал и правил в течение трёх сессий и 130 вызовов инструментов. Этот pull request до сих пор открыт.
Когда мы разобрались, куда ушли деньги, оказалось, что дело не в медленной или ошибающейся модели. Дело было в кэше. В этом прогоне Opus читал из кэша только 8% промпта. GLM 5.3, работавшая в том же прогоне, читала из кэша 99% промпта. Поэтому каждый из 111 вызовов Opus платил заново за промпт примерно в 100 тыс. токенов.
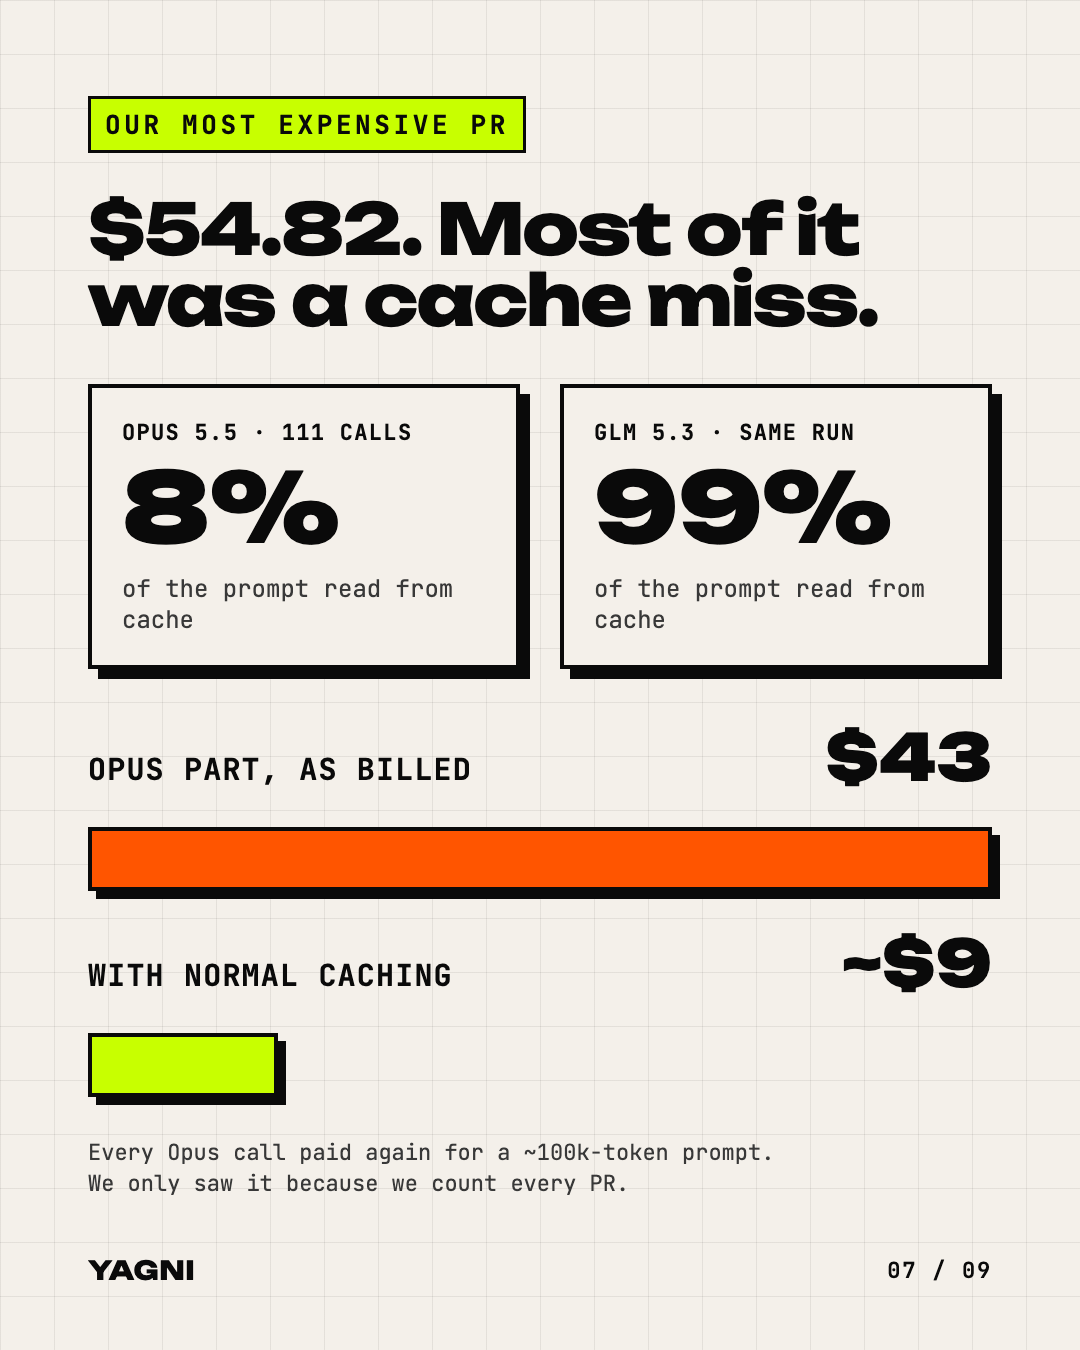
Часть Opus в этом тикете стоила $43. При нормальном проценте попаданий в кэш она стоила бы около $9. Остальные прогоны Opus на этом проекте выглядели так же: из кэша читалось от 6 до 17% промпта. Значит, это баг на нашей стороне, а не невезение.
Вывод не в том, что Opus дорогой. В том, что кэш, который не попадает, может в несколько раз удорожить любую модель, и заметить это можно, только если считать по каждому pull request.
Что я сделал неправильно на прошлой неделе
На прошлой неделе я написал, что один PR на настоящую фичу стоит около $82 на Opus и $13 на открытых моделях (пост).
Часть про мелкие тикеты подтверждается. Я оценивал $0,63 за PR на открытых моделях по списочным ценам, а медиана, которую мы измерили, — $0,61.
$82 была расчётом, а не измерением: среднее число токенов на PR, умноженное на в 10–100 раз больше токенов, которые мы видели на настоящих фичах, и на списочные цены Opus. Ни один PR из наших записей не стоил $82. Самый дорогой из них — тот самый $54,82 выше.
Главная проблема в самом соотношении. Сравнение $82 с $13 предполагает, что обе модели тратят одинаковое число токенов, а это не так. На стейджинге у нас есть три пары похожих тикетов, каждый сделан один раз на Opus и один раз на открытых моделях, с разницей в неделю:
- Эндпоинт
/api/version: $2,11 на Opus за одну попытку и $34,63 на открытых моделях за 12 попыток. - Проверка оттенков цветов в нашем CSS: $5,85 на Opus, $5,37 на открытых моделях.
- Обязательные переменные окружения: $44,68 на Opus, $36,27 на открытых моделях.
Прогоны на открытых моделях тоже могут уйти вразнос. Один тикет сделал 1 648 вызовов инструментов и стоил $32,89, прежде чем упал.
Эти пары не идентичные тикеты, прогоны на открытых моделях шли на более старой версии нашего харнесса, а три пары — это анекдот, а не исследование. Но этого достаточно, чтобы поправить то, что я писал. Цена за токен — один из множителей, и далеко не самый большой. Число попыток и процент попаданий в кэш двигают счёт сильнее.
Что мы с этим делаем
- Мы считаем каждый pull request в токенах, долларах и попытках. Именно поэтому мы нашли баг с кэшем.
- Каждый таск уходит к самой дешёвой модели, которая проходит наши проверки. Клиенты модель не выбирают: они получают результат и то, сколько он стоил.
- Дешёвое имеет смысл, только если его проверяют. Падающий тест идёт раньше кода, а отдельный агент пытается сломать результат. Я писал про бенчмарк ревьюер-моделей на наших PR здесь.
- Цикл останавливают, а решения о том, что уходит в прод, принимают люди: мержи, фича-флаги и сообщения клиентам.
Когда придёт следующая встреча по бюджету, «мы используем AI» не будет ответом. Ответом будет: «Pull request стоит нам $0,61 в медиане, вот наш самый дорогой, и вот почему».
Если хотите посмотреть, как это работает на ваших репозиториях, этим мы и занимаемся в YAGNI.