Я хотел проверить простую идею: может ли небольшая модель стать полезнее в программировании, если между попытками учиться на собственном опыте? Не на синтетической библиотеке, а на задачах реального проекта.
За ночь я получил 235 свежих ответов от пяти вариантов одной модели. Ни один не решил ни одной из семи отложенных задач. Это предварительный отрицательный результат. Он оказался полезнее, чем красивая история об агенте, который «поумнел во сне»: пришлось разбираться, что именно мы вообще измеряем.
Что я называл опытом
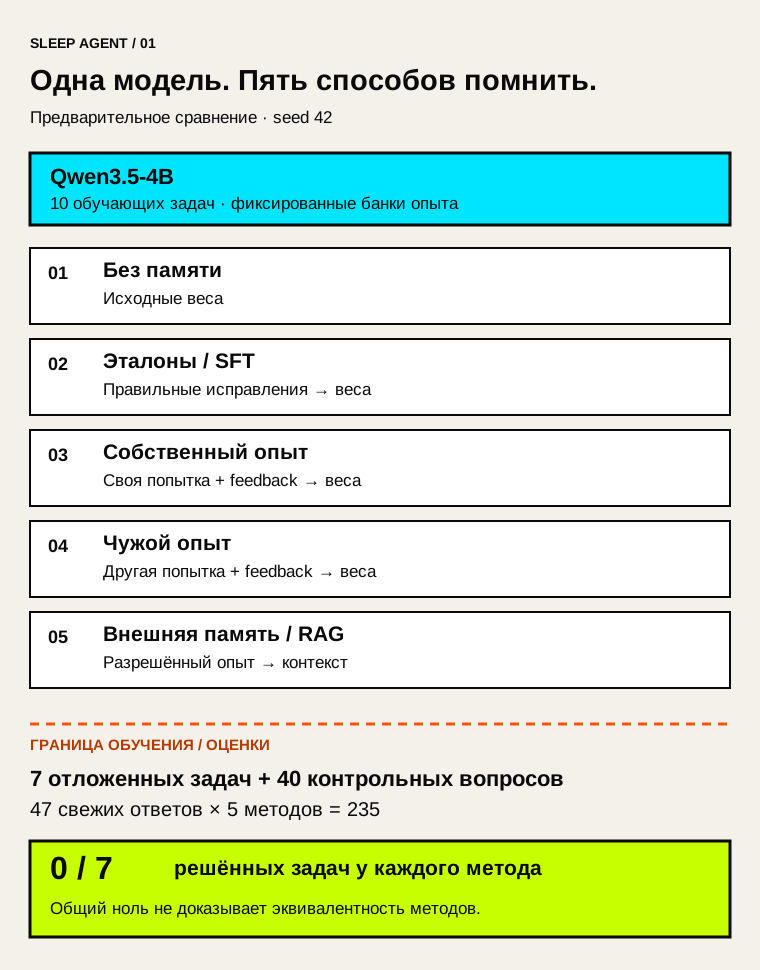
Я взял Qwen3.5-4B и Goose Mini Browser — реальный проект на языке Goose. Это отдельный язык, не Go. Десять задач использовались для обучения, семь оставались для оценки: три основные и четыре задачи переноса внутри того же репозитория.
Сравнивались пять вариантов:
- Исходная модель без дообучения и постоянной памяти.
- SFT: обучение на правильных исправлениях.
- Собственный опыт: банк попыток своего прогона, обратная связь и правильное исправление.
- Чужой опыт: аналогичный материал другого прогона.
- RAG: исходная модель с внешней памятью из разрешённого опыта.
Контроль с SFT здесь принципиален. Если обученный вариант обходит исходный, это ещё не означает, что помогли именно собственные ошибки. Возможно, модель просто получила правильные ответы. В вариантах с опытом предыдущая неудача была контекстом, а функция потерь обучала только финальному исправлению.
Что было запущено за ночь
Для всех пяти вариантов я заново получил ответы на одни и те же семь задач и 40 контрольных вопросов. Получилось 47 ответов на метод, 235 всего. Использовались seed 42, жадное декодирование и финальные адаптеры третьего цикла из фиксированных банков опыта. Бюджет ответа — 4096 новых токенов для исправления и 384 для контрольного вопроса.
Это сокращённая ветка большого эксперимента. В исходном плане были три seed, несколько циклов и отдельная адаптивная фаза. Сокращение бюджета с 9216 до 4096 токенов было принято после наблюдения исходного baseline и медленной части SFT. Поэтому ночное сравнение нельзя выдавать за новое независимое подтверждающее исследование.
Модель получала заранее локализованные фрагменты кода и должна была вернуть строгий JSON с точными заменами. Это проверка исправлений в заданном контексте. Автономное изучение всего репозитория здесь не измерялось.
Ноль решённых задач — но разные способы проиграть
У всех пяти методов результат одинаковый: 0 из 3 основных задач и 0 из 4 задач переноса. Считать методы равноценными по этим числам нельзя: семь задач и общий нулевой результат плохо различают их возможности.
Разница видна раньше, на проверке самого исправления. У исходной модели до исполнения дошли 6 из 7 ответов; у SFT — 2, у собственного опыта — 1, у чужого опыта и RAG — ни одного.
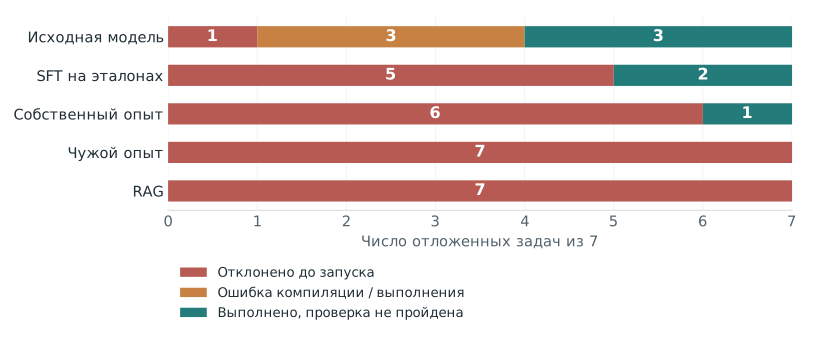
Непринятый ответ не всегда означал сломанный JSON. Проверялись и точные замены: пустой старый фрагмент, изменение без эффекта и повторяющийся ключ тоже отклонялись. Из шести принятых исправлений исходной модели три не прошли компиляцию или выполнение, а три выполнились, но не решили задачу. Два принятых исправления SFT и одно собственного опыта тоже оказались неверными.
Лимит генерации был достигнут в двух ответах SFT и трёх ответах каждого варианта с опытом. Сам по себе этот счётчик не доказывает обрыв до конца ответа. У RAG таких случаев не было, хотя пригодных исправлений он тоже не выдал.
На контрольных вопросах стало лучше. Что это значит?
На 40 вопросах исходная модель получила 17 правильных ответов, SFT — 21, собственный и чужой опыт — по 24, RAG — 18. Это 42,5%, 52,5%, 60%, 60% и 45% соответственно.
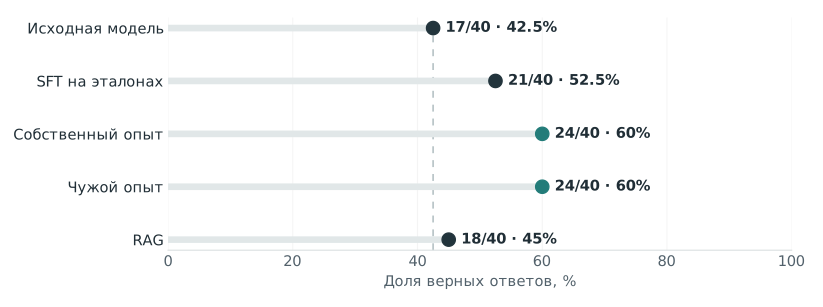
Вопросы взяты из прежнего development-набора. Это проверка общих навыков на знакомом исследованию материале, а не независимый широкий бенчмарк и не доказательство нового знания Goose.
Суммарный балл также скрывает потери. Собственный опыт исправил девять прежних ошибок относительно исходной модели, но потерял два верных ответа. Чужой опыт приобрёл восемь и потерял один. RAG приобрёл пять и потерял четыре. SFT приобрёл четыре без потерь.
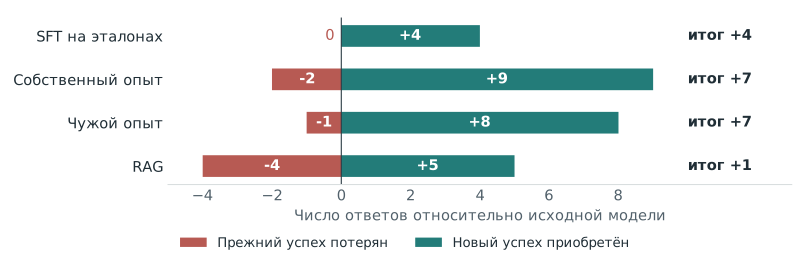
В прямом сравнении собственного опыта с SFT пять вопросов выиграл опыт, два — SFT. Разница в три ответа из сорока интересна для следующего прогона. На одном seed она ещё не устанавливает преимущество метода. Равные 24 балла у собственного и чужого опыта не устанавливают их эквивалентность.
Проверка: не сломали ли мы обучение?
После ночного прогона я проверил обучающие данные и маски, не меняя отложенные задачи. В 27 запусках было 90 записей — это десять разных задач, повторённых по трём условиям и трём seed. Независимых задач от этого не стало девяносто.
Все 90 целевых ответов разбираются как строгий JSON и точно применяются к своим обучающим снимкам. Повторное кодирование восстановило исходные хеши токенов, меток и масок для всех записей. Неверная предыдущая попытка замаскирована; обучение направлено на финальное исправление. В журналах всех 27 запусков конечный loss и изменение 256 тензоров. Это подтверждает, что обучение происходило, но не доказывает обобщение.
Нашлись две гипотезы для продолжения. Ветки с опытом учились на диалоге из пяти сообщений, где исправление следует за неудачей и обратной связью. На оценке требовался первый ответ. Такой разрыв контекста может мешать, но сам по себе не объясняет ухудшение SFT, у которого этого разрыва нет.
Кроме того, две обучающие цели длиннее ночного бюджета: 8604 и 5303 токена против 4096 на ответ. Все эталоны отложенных задач в бюджет помещаются. Значит, ограничение длины стоит проверить отдельно, но объявлять его причиной провала пока нельзя.
Сколько это стоило и можно ли было играть в Dota
Суммарное время успешных процессов было около 4 часов 59 минут. Собственно генерация занимала внутри него около 1 часа 49 минут. Это вложенные величины: складывать их нельзя.
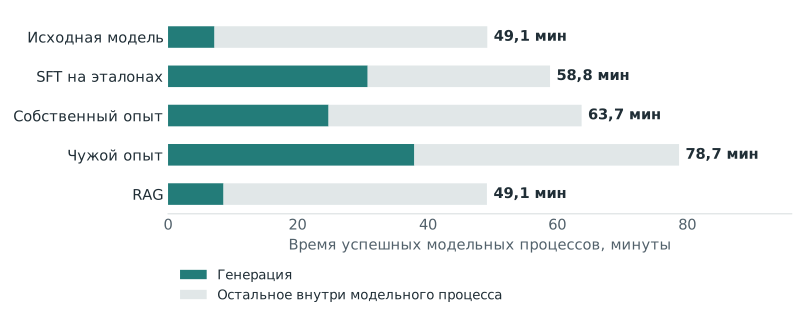
Каждая задача запускалась в свежем процессе. Остальное время включало проверку хешей, импорты, загрузку, завершение и наблюдение за процессами. Это не замер одной только загрузки модели. Подготовка, обучение, ожидание игры и часть неудачных запусков в этот итог не входят; это не полная стоимость исследования.
При запуске Dota текущий рабочий процесс действительно останавливался, а после выхода из игры та же задача выполнялась повторно. Прерванный ответ исключён из оценки. FPS, задержки игры и скорость освобождения видеопамяти я не измерял, поэтому обещать отсутствие влияния на игру по этому наблюдению нельзя.
Позднейшая диагностическая проба остановилась ещё до загрузки модели: Windows Application Control заблокировал модуль pandas. Она не дала новых ответов и не объясняет уже завершённые ночные нули. Проверка данных и масок прошла на CPU без отключения защиты Windows. Совместимость дальнейшего GPU-прогона осталась непроверенной.
Что я готов утверждать
На этом наборе и в этих условиях полезного переноса на отложенные задачи я не увидел. После обучения модель чаще возвращала непригодные исправления. На контрольных вопросах сумма правильных ответов выросла, причём часть ранее правильных ответов потерялась.
Я не могу из этого заключить, что модели не учатся на опыте или что внешняя память хуже дообучения. Один seed, один репозиторий и семь задач для этого слишком мало. Неизвестно и то, встречалась ли публичная история проекта в предобучении модели.
Разделение данных контролировалось входными пакетами и сохранёнными хешами. Решатель не вызывал инструменты, но доверенный Python-хост имел доступ к файлам. Это не полная техническая изоляция знаний.
Следующий полезный шаг — проверить формат ответа и разрыв обучающего контекста на development-задачах, заранее зафиксировать изменения, а затем выполнить повторения без подстройки по этим семи задачам. Полная программа сейчас приостановлена.
Вопрос о том, когда опыт выгоднее хранить в весах, а когда во внешней памяти, остаётся одним из возможных выводов будущего исследования. Ночной прогон его не решил.
Данные и воспроизводимость
Сводные результаты ночного сравнения содержат условия прогона и числа графиков. Это публичная сводка, не полностью автономное воспроизведение обучения. Полные отчёты, хеши входов и результаты CPU-аудита сохранены в локальном исследовательском архиве; в эту публикацию они не входят.
Модель: Qwen3.5-4B, revision 851bf6e806efd8d0a36b00ddf55e13ccb7b8cd0a. Это предварительное исследование, завершённое ночное сравнение пяти методов, не завершение всей программы.